1. Servelt : Java기반의 웹 프로그래밍 기술, thread기반의 빠른 처리속도가 장점.
2.HTTP특징
-비 연결 : 클라이언트 요청에 응답 후 바로 연결을 끊음(과부하 방지)
-비 상태 : 서버의 상태가 어떤지 상관없이 요청
http : (프로토콜) 통신규약
localhost : 호스트, 내부아이피, 실제아이피 3개중에 사용
80 : 인터넷 접속시 사용하는 포트 (보여지진 않음)
8080 : 포트번호(테스트 포트)
ServletMain : 컨텍스트 루트
3.Servlet의 패키지 및 주요 객체
패키지
-javax.servlet : 패키지는 프로토콜에 독립적인 서블릿을 만들기 위한 클래스
-javax.servlet.http : 패키지는 HTTP프로토콜의 고유한 기능(GET,POST 등)을 제공
주요객체
-HttpServletRequest : HTTP요청에 대한 기능 제공
_HttpServletResponse : HTTP응답에 대한 기능 제공
*request : 클라이언트 요청정보가 담긴다.
*response : 클라이언트에게 보낼 정보가 담긴다.
2013년 8월 27일 화요일

2013년 8월 19일 월요일
Statement VS PreparedStatement
Statement
소스 가독성 : SQL문이 복잡할 수록 읽기 어렵다.
바이너리 데이터 입력 : 입력불가.
반복 수행시 속도 : 매번 SQL문을 DBMS에 형식에 따라 속도 느림.
성능 : SQL문을 매번 컴파일 후 사용.
사용법 : 매번 SQL문을 지정해준다.
Prepared Statement
소스 가독성 : 간결하다.
바이너리 데이터 입력 : 입력가능.
반복 수행시 속도 : SQL문을 한번만 변환하고 실행하여 속도 빠름.
성능 : 컴파일한 상태에서 바인딩
사용법 : SQL문에서의 ?의 변화만 준다.
소스 가독성 : SQL문이 복잡할 수록 읽기 어렵다.
바이너리 데이터 입력 : 입력불가.
반복 수행시 속도 : 매번 SQL문을 DBMS에 형식에 따라 속도 느림.
성능 : SQL문을 매번 컴파일 후 사용.
사용법 : 매번 SQL문을 지정해준다.
Prepared Statement
소스 가독성 : 간결하다.
바이너리 데이터 입력 : 입력가능.
반복 수행시 속도 : SQL문을 한번만 변환하고 실행하여 속도 빠름.
성능 : 컴파일한 상태에서 바인딩
사용법 : SQL문에서의 ?의 변화만 준다.


2013년 8월 8일 목요일
추상클래스
| 추상클래스란? |
추상클래스(abstract class)는 추상적인 클래스로써 그 구현이 덜 되었거나 또는 아직은 미완성 클래스이므로 실제 인스턴스(또는 객체)를 생성할 수 없도록 한 클래스입니다. 다시 말해서, 추상클래스는 객체가 가지는 특성들을 추상화시켜 놓았을 뿐 아직 구체화 시키지 못한 클래스이므로, 이 추상클래스를 상속하는 하위클래스에서 좀 더 구체화 시키도록 하는 것입니다.
따라서, 추상클래스를 상위클래스로 하여 상속하는 하위클래스는 추상클래스인 상위클래스에서 완전히 구현하지 못한 부분들을 완전하게 구현해 주어야만 하위클래스에 대한 객체 생성이 가능하고, 그렇지 못할 경우 하위클래스는 상위클래스인 추상클래스와 같이 미완성이므로 자체적으로 객체를 생성할 수 없고, 이 하위클래스는 다시 추상클래스가 됩니다.
|
| 2 | 추상메소드는 추상클래스와 마찬가지로 아직 구현이 이루어지지 않고 단지 그 프로토타입만을 가지고 있는 메소드를 말합니다. |
추상메소드는 미완성 메소드이어야 하므로, 메소드의 몸체(body)를 가질 수 없습니다. 추상메소드는 클래스가 가져야 할 인터페이스에 대한 프로토타입(메소드의 형태)을 정의하고 있습니다. 추상메소드는 하위클래스가 가져야 할 인터페이스를 정의합니다. 추상메소드를 포함하는 클래스는 반드시 추상클래스로 선언되어야 합니다.
추상클래스는 추상메소드를 포함할 수 있고, 추상메소드를 포함하는 클래스는 반드시 추상클래스로 선언되어야 합니다. 추상메소드를 포함하고 있는 추상클래스를 상속하는 하위클래스는 추상클래스가 갖고 있는 모든 추상메소드를 구현하여 주어야 합니다. 그럴 경우, 하위클래스는 하나의 클래스처럼 사용할 수 있고, 인스턴스의 생성도 가능하지만, 추상메소드를 모두 구현해 주지 못한 경우에는 하위클래스도 구현이 완전히 이루어지지 않은 추상메소드를 포함하게 되므로 추상클래스가 되며,
이 때 반드시 추상클래스로 선언되어야 합니다. 그렇지 않을 경우 다음과 같은 에러가 발생합니다. 이러한 추상 클래스(abstract class)와 추상 메소드는 해당 클래스와 메소드의 앞에 abstract 키워드를 사용하여 선언할 수 있습니다.
|
| 3 | 추상클래스의 선언방법 |
abstract class 클래스이름 {
abstract 메소드선언; // 메소드의 몸체는 없음
}
예)
abstract class AbstractClass {
abstract void abstractMethod();
}
|
Binary, Character 입출력에대해서
Binary | Character
----------------------------------------|-----------------------------------
| 1 byte 단위 read / write | 문자셋에 따라 다르다
| Input Stream (추상) | Reader (추상)
| ↑ | ↑
입력| FileInputStream(File) | FileReader(File)
| ByteArrayInputStream(Memory) | CharArrayReader(Memory)
| PipedInputStream(Process) | StringReader(Memory)
| | PipedReader(Process)
----|------------------------------------+------------------------------------
| OutputStream(추상) | Writer(추상)
| ↑ | ↑
| FileOutputStream(File) | FileWriter(File)
| ByteArrayOutputStream(Memory) | CharArrayWriter(Memory)
출력 | PipedOutputStream(Process) | StringWriter(Memory)
| | PipedWriter(Process)
----|-------------------------------------------------------------------------
----------------------------------------|-----------------------------------
| 1 byte 단위 read / write | 문자셋에 따라 다르다
| Input Stream (추상) | Reader (추상)
| ↑ | ↑
입력| FileInputStream(File) | FileReader(File)
| ByteArrayInputStream(Memory) | CharArrayReader(Memory)
| PipedInputStream(Process) | StringReader(Memory)
| | PipedReader(Process)
----|------------------------------------+------------------------------------
| OutputStream(추상) | Writer(추상)
| ↑ | ↑
| FileOutputStream(File) | FileWriter(File)
| ByteArrayOutputStream(Memory) | CharArrayWriter(Memory)
출력 | PipedOutputStream(Process) | StringWriter(Memory)
| | PipedWriter(Process)
----|-------------------------------------------------------------------------
2013년 8월 6일 화요일
Value Object에 대해서
Value Object
>J2EE 패턴중의 하나로 화면의 입력값을 정리하여 보관 및 유지해주는 Class
>데이터를 전달하는 Class
>setter, getter 클래스
Value Object Pattern
1. 데이터 베이스에 포함된 데이터의 논리적인 view를 표현
2. 데이터들의 관계를 추상화하는 방법
3. 다양한 Data Source로부터 가져온 데이터를 단일 인터페이스로 표현.
>J2EE 패턴중의 하나로 화면의 입력값을 정리하여 보관 및 유지해주는 Class
>데이터를 전달하는 Class
>setter, getter 클래스
Value Object Pattern
1. 데이터 베이스에 포함된 데이터의 논리적인 view를 표현
2. 데이터들의 관계를 추상화하는 방법
3. 다양한 Data Source로부터 가져온 데이터를 단일 인터페이스로 표현.
2013년 8월 5일 월요일
HDD 구조에 대해서
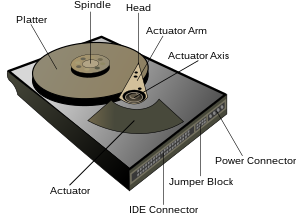
원리적으로, 컴퓨터에 저장되는 모든 데이터는 0,1 두 디지털 신호에 의해 이루어진다. 하드 디스크의 경우 이러한 디지털 신호를 원반형태의 플래터에 기록한다. 디지털 신호의 기록은 자기장의 밀도 변화를 이용해 기록한다. 좀더 자세하게 말하면, 자기장의 밀도 변화를 측정하는 바늘(헤드)가 플래터 위의 일정한 간격을 지나치는 동안 자기장의 극성이 변화하면 1, 그렇지 않으면 0으로 인식한다. (=2013년 현재 1회분의 신호는 20nm(10억분의 20미터)에 해당하는 간격마다 저장된다)
자기장을 이용한 기계적 구조로 구성된 하드 디스크는 반도체 기반의 저장 매체에 비해 진동, 충격, 자성등의 외부 환경에 취약하다. 또한, 하드 디스크 외부는 소음 발생과 외부의 먼지 유입을 최소화하기 위해서 최대한 밀폐적인 구조로 설계되어 있다. 하지만 하드디스크에는 내부의 기압을 대기압과 동등하게 해주는 작은 구멍이 뚫린 씰이 있어 외부 환경에 따라 먼지 등이 유입될 수 있기 때문에 외부 환경에 의한 수명 편차가 크다.
- 제어회로
- 하드 디스크를 제어하는 회로로 총괄적인 부분을 제어한다. 또한 제어회로에 있는 버퍼 메모리는 하드 디스크에 입출력될 데이터를 임시로 저장하게 된다. 또한S.M.A.R.T. 기술이 내장된 하드 디스크는 자가 문제 진단을 할 수 있으며, 문제를 발견시에는 부팅시에 사용자에게 보고하게 된다. 단 바이오스가 S.M.A.R.T. 기술을 지원하지 않거나 사용안함으로 설정된 경우에는 사용자에게 보고하지 않는다.
- 스핀들 모터 (Spindle Motor)
- 플래터의 회전을 담당한다. 브러시리스 모터를 이용하여 구동하기 때문에 모터의 제어회로가 따로 필요하게 된다. 초기에는 볼 베어링을 사용했지만 유체를 사용함으로써 볼의 마모로 인한 수명 문제가 개선된 동압 유체 베어링이 개발되면서 동압 유체 베어링으로 대체되었다. 동압 유체 베어링이 적용되면 거의 완전하게 원형 회전을 할 수 있어 트랙 밀도를 높일 수 있다.
- 플래터 (Platter)
- 데이터가 기록되는 부분이다. 플래터는 금속재질이지만, 거울과 같이 반사가 잘 될 정도로 래핑상태가 부드러우며, 데이터를 기록하기 위해 산화철등의 자성체로 코팅되어 있다. 하나의 하드 디스크에는 한개 또는 그 이상의 플래터가 장착되어 있다. 플래터 수가 많으면 더 큰 용량을 저장할 수 있지만, 안정성에는 문제가 생길 수 있다.
- 액추에이터(=액튜에이터) (Actuator)
- 헤드가 원하는 데이터를 읽을 수 있게 제어회로의 명령에 따라 액추에이터 암을 구동하는 역할을 한다. 구동을 위해 네오디뮴 자석이 있으며, 누설자속을 줄이기 위해 철과 같은 강자성체 재질로 된 자석 덮개가 있다. 액추에이터는 명령어 대기열(Command queuing) 기술을 통해 구동을 최소화하여 여러개의 파일을 효율적으로 입출력 할 수 있다. 단 명령어 대기열 기술을 사용할 때에는 하드 디스크와 ICH 칩셋이 모두 커맨드 큐잉 기술을 지원해야 사용이 가능하다. 초창기의 하드 디스크는 스테핑 모터로 액추에이터를 구동하여 데이터 손실을 방지하기 위해 헤드 파킹이 필요하였으나, 현재는 음성 코일 방식으로 액추에이터가 구동되어 하드 디스크의 전원 공급이 중단될 경우에는 스핀들 모터의 관성으로 헤드가 자동으로 제자리로 파킹되기 때문에 헤드 파킹은 더이상 필요하지 않다.[1]
- 액추에이터 암 (Actuator arm)
- 액추에이터를 통해 구동되며, 하나의 하드 디스크에는 여러 개의 암이 달려있다. 앞 뒷면을 모두 사용하기 때문에, 각 플래터 당 두 개의 암이 달려있다. 각 암의 끝에는 입출력을 위해 헤드가 달려 있다.
- 헤드 (Head)
정수형 (byte, short, int, long) 에 대해서
<< 정수형 >>
- 용도 : 정수값을 저장
- 크기 : 크기에 따라서 다음 4가지로 분류할 수 있다.
byte 1 byte(-128 ~ +127)
short 2 byte(-32,768 ~ +32,767)
int 4 byte(-2,147,483,648 ~ +2,147,483,647)
long 8 byte(-9,223,372,036,854,775,808L ~ +9,223,372,036,854,775,807L)
<< 정수의 표현 >>
- 0 ~ 9 까지의 숫자를 사용하여 표현.
- 기본적으로 10진수를 사용.
- 진수의 표현
10진수 : 65
16진수 : 0x41 또는 0X41 (0x 또는 0X 접두어를 붙이고 0 ~ 9, A ~ Z 까지 숫자로 표현)
대소문자 구분은 하지 않는다!
8진수 : 0101 (0 접두어를 붙이고 0 ~ 7까지 숫자로 표현)
즉, 65(10진수) = 0X41(16진수) = 0101(8진수) 가 된다.
- 2진수는 표현할 수 없다. 보통 16진수로 표현한다.
<< int 형 정수와 long 형 정수 >>
- 기본적으로 123 등과 같은 수의 표현은 int 형(4바이트) 정수를 의미한다.
- long 형(8바이트) 정수의 표현은 숫자 뒤에 접미사 L 또는 l 을 붙인다.
예) 123L, 0xA3l, 0Xa3L 등
- 따라서 123 과 123L은 같은 정수이지만 크기가 틀린 정수이다.
- 용도 : 정수값을 저장
- 크기 : 크기에 따라서 다음 4가지로 분류할 수 있다.
byte 1 byte(-128 ~ +127)
short 2 byte(-32,768 ~ +32,767)
int 4 byte(-2,147,483,648 ~ +2,147,483,647)
long 8 byte(-9,223,372,036,854,775,808L ~ +9,223,372,036,854,775,807L)
<< 정수의 표현 >>
- 0 ~ 9 까지의 숫자를 사용하여 표현.
- 기본적으로 10진수를 사용.
- 진수의 표현
10진수 : 65
16진수 : 0x41 또는 0X41 (0x 또는 0X 접두어를 붙이고 0 ~ 9, A ~ Z 까지 숫자로 표현)
대소문자 구분은 하지 않는다!
8진수 : 0101 (0 접두어를 붙이고 0 ~ 7까지 숫자로 표현)
즉, 65(10진수) = 0X41(16진수) = 0101(8진수) 가 된다.
- 2진수는 표현할 수 없다. 보통 16진수로 표현한다.
<< int 형 정수와 long 형 정수 >>
- 기본적으로 123 등과 같은 수의 표현은 int 형(4바이트) 정수를 의미한다.
- long 형(8바이트) 정수의 표현은 숫자 뒤에 접미사 L 또는 l 을 붙인다.
예) 123L, 0xA3l, 0Xa3L 등
- 따라서 123 과 123L은 같은 정수이지만 크기가 틀린 정수이다.
데이터형 boolean
<< boolean >>
- 용도 : true, false 값 저장.
- JVM(Java Virtual Machine) 에서 내부적으로 true 는 1, false 는 0 의 값으로 취급한다.
내부적으로 1과 0의 int 값으로 저장된다고 해서 boolean 변수에
직접 1 or 0 값을 저장할 수는 없다.
- boolean 배열은 JVM에서 내부적으로 byte 배열을 사용한다.
- 용도 : true, false 값 저장.
- JVM(Java Virtual Machine) 에서 내부적으로 true 는 1, false 는 0 의 값으로 취급한다.
내부적으로 1과 0의 int 값으로 저장된다고 해서 boolean 변수에
직접 1 or 0 값을 저장할 수는 없다.
- boolean 배열은 JVM에서 내부적으로 byte 배열을 사용한다.
변수의 선언과 변수명
<< 변수의 선언 >>
- Data를 저장하기 위한 메모리 생성을 의미.
- 저장할 Data의 "용도" 와 "크기"를 나타내는 Data 형을 지정하고
그 용도와 크기에 따라 만들어질 "메모리의 이름(변수명)"을 지정하면 된다.
예) 용도는 '정수'를 담기위함, "크기"는 1byte 정도의 값을 저장.
byte : 자료형
b; : 변수명
- 같은 Data형의 변수 여러개를 한꺼번에 선언 할 수 있다.
예) byte b1;
byte b2;
byte b3;
--> 아래와 같이 한꺼번에 선언
byte b1, b2, b3;
- 변수 선언과 더불어 초기화 할 수 있다.
예1) byte b1;
b1 = 100;
--> 다음과 같이 변수선언과 초기화를 함께 할 수도 있다.
byte b1 = 100;
예2) byte b1, b2, b3;
b1 = 10;
b2 = 20;
b3 = 30;
--> 다음과 같이 여러변수의 선언과 초기화를 함께 할 수 있다.
byte b1 = 10, b2 = 20, b3 = 30;
- 변수명의 첫 글자는 반드시 자바 문자가 와야 한다.
자바문자 : A ~ Z, a ~ z, _, $, 기타 유니코드가 지원하는 다국어 문자.
- 첫글자를 제외 나머지 글자는 숫자(0 ~ 9)가 올 수 있다.
- 예)
A~Z, 정수2, _도움기술, $도움기술, _123, $234
<< 초기화 하지 않은 변수의 사용 >>
- 변수를 초기화 하지 않고 사용하면 컴파일시에 Error 발생
2013년 8월 2일 금요일
CVS (형상관리 관련 툴) 대해서..
1. CVS란 무엇인가?
Concurrent version system의 약자로 버전 관리 툴이다. 흔히 작은 규모로 프로그램을 작성 할 때는 버전 관리 툴을 사용하지 않는다고 한다. 즉, 중급 규모 이상 여러 사용자가 공동 작업으로 프로그램을 작성할 때 사용한다고들 한다. 물론 맞는 말인 것 같다. 그러나 그렇게 작업해서 늘어나는 work 폴더 안의 프로젝트들…, 그리고 늘어나는 Backup 폴더 안의 날짜를 이름으로 하는 프로젝트들… 도저히 감당하기가 어렵다. 이런 필요성에 의해 작은 프로젝트를 하는 사람도 버전 관리 툴이 필요하다고 생각한다.
Concurrent version system의 약자로 버전 관리 툴이다. 흔히 작은 규모로 프로그램을 작성 할 때는 버전 관리 툴을 사용하지 않는다고 한다. 즉, 중급 규모 이상 여러 사용자가 공동 작업으로 프로그램을 작성할 때 사용한다고들 한다. 물론 맞는 말인 것 같다. 그러나 그렇게 작업해서 늘어나는 work 폴더 안의 프로젝트들…, 그리고 늘어나는 Backup 폴더 안의 날짜를 이름으로 하는 프로젝트들… 도저히 감당하기가 어렵다. 이런 필요성에 의해 작은 프로젝트를 하는 사람도 버전 관리 툴이 필요하다고 생각한다.
CVS는 단어 뜻대로 최신 버전만 관리하나? 절대 아니다. CVS는 Visual Source Safe등과 같이 Co-work를 할 수 있도록 지원하기도 한다. 이 기능이 없으면 앙꼬 빠진 찐빵이라 할 수 있을 것이다.
구성은? CVS는 버전을 관리하는 서버와 서버에 등록된 사용자가 사용하는 클라이언트로 구성된다. 서버는 FreeBSD, Linux, Solaris, windows 등의 OS에 설치 가능하다. 물론 설치 가능한 버전은 따로 있다. ^^ 윈도우 사용자로서 클라이언트는 보통 두 가지를 쓰게 된다. 하나는 탐색기 비슷하게 생긴 wincvs이다. 이 프로그램은 독립된 어플리케이션으로서 여러 CVS 메시지를 대화상자를 통해 처리하게 하는 프로그램이다. 또 하나는 Tortoise CVS 라는 툴이다. 이 툴은 윈도우 탐색기에 껴서 팝업 메뉴에서 쉽게 CVS를 사용할 수 있도록 하는 툴이다. 그냥 둘 다 깔아 보고 사용해 보다가 익숙해 지는 것 사용하는 것이 가장 좋은 것 같다.
CVS를 사용하려면 몇 가지 용어에 익숙해 져야 한다. Import : 버전 관리하고자 하는 프로그램을 서버에 등록하는 역할을 한다.
Check Out : 서버에서 버전 관리중인 프로젝트를 취득한다.
Commit : 취득한 프로젝트를 변경 후에 서버에 저장한다.
Update : 서버에서 바뀐 내용이 있는 파일을 다운로드 한다.
Add, Remove : 서버 관리하의 프로젝트에 파일을 추가하거나 삭제한다.
2013년 8월 1일 목요일

Java언어의 특징
Java언어의 특징
1.플랫폼에 비의존적인 프로그래밍이 가능하다.
2.소프트웨어적(OS 운영체제)에서 벗어난 컴파일, 인터프리터 언어이다.
*컴파일언어 = 소스를 만든후 컴파일을해서 실행시키는것.
*인터프리터언어 = 운영체제에 상관없이 실행이 가능하지만 시간이 더오래걸린다는 단점을 가짐.
JVM(Java Virtual Machine)을 사용하는 이점
1.자동가비지컬렉션(Auto Garbage Collection)을 지원한다
*가비지 = 더이상 사용하지 않는 동적할당 메모리
2.동적로딩을 지원한다
3.플랫폼에 무관한 멀티 스레드 프로그래밍이 가능하다.
피드 구독하기:
글 (Atom)